 Deutsch
 Français
 English
Système de commande
Les clients peuvent créer un compte eux-mêmes ou recevoir leurs identifiants de connexion automatiquement lors d’une migration par lots.
TTN propose un système de commande en trois clics : Sélectionner la langue ➛ Déposer des fichiers ➛ Sélectionner un délai convenable.
Lorsque le client souhaite commander une traduction, le système lui demande de sélectionner la langue cible.

Figure 1 : Sélection des langues cibles
La liste présente un ensemble de langues prédéfinies. Si nécessaire, les utilisateurs peuvent choisir plus de 150 langues. Les suggestions initiales sont générées dynamiquement à partir de statistiques d’utilisation récentes afin de rationaliser et d’accélérer le processus de commande.

Figure 2 : Sélection du mode de traduction et du délai
Une fois le chargement terminé, le système propose immédiatement sept délais possibles et les affiche sous forme d’options sélectionnables. L’expérience montre que 90 % des utilisateurs acceptent l’un des délais de livraison proposés et cliquent simplement sur « OK ». En plus de ces sept suggestions, les utilisateurs peuvent également choisir un délai de livraison personnalisé dans le calendrier de récupération proposé. Si l’utilisateur choisit un délai de livraison qui n’est pas réalisable, le système affiche un avertissement approprié.

Figure 3 : Le client peut choisir son propre délai.
L’écran de commande est entièrement paramétrable. Les prix peuvent être remplacés par des points, le tarif express peut être supprimé et les modes de traduction peuvent être réduits ou étendus. Le paramétrage s’effectue par l’intermédiaire du registre ou de l’interface opérateur du système.
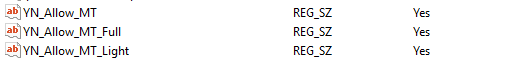
Figure 4 : Paramétrage via le registre ou l’interface opérateur du système
Les délais sont calculés en fonction de la disponibilité des ressources de traduction. Ils peuvent être paramétrés pour chaque utilisateur ou groupe d’utilisateurs individuellement.
Mode de traduction et schémas du flux de travail
Le mode de traduction correspond à différents flux de travail avec des modèles de tarification ou d’effort distincts. Dans cet exemple, quatre options de flux de travail sont présentées. TTN TMS est un système modulaire qui permet de configurer facilement chaque flux de travail en fonction des besoins spécifiques.
Traduction classique
Dans le modèle de traduction classique, le texte est traduit par un traducteur humain, puis soigneusement corrigé par un relecteur. Le responsable de la traduction supervise le processus, en particulier s’il y a plusieurs langues cibles, en veillant à ce que le formatage soit cohérent dans toutes les langues. Il examine les fichiers sources pour vérifier s’ils contiennent des images. Si nécessaire, il organise des fichiers vectoriels afin qu’ils puissent être écrasés, ou place des zones de texte couvrant la légende des pixels afin que les traducteurs puissent y accéder en mode segmenté dans l’éditeur XLIFF.
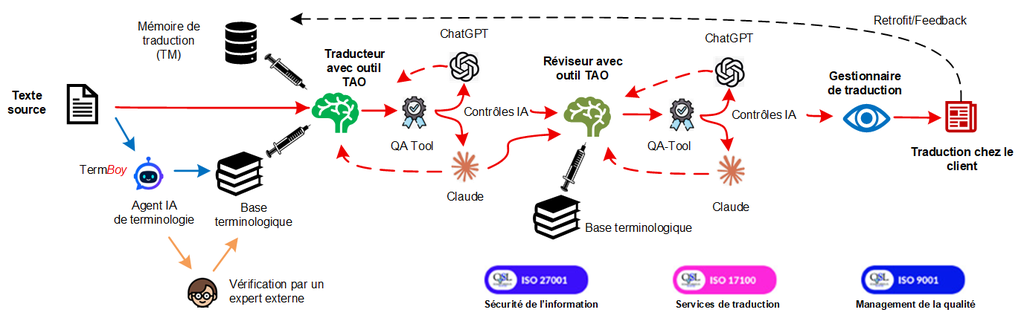
Figure 5 : Flux de travail de la traduction classique
Avant le début de la traduction, TTN TMS met à disposition les ressources linguistiques : la mémoire de traduction et la base terminologique du client sont attribuées au projet et connectées à l’outil de TAO. En parallèle, l’agent IA TermBoy analyse le texte source à la recherche de termes spécialisés qui manquent encore dans la base terminologique. Il recherche ces termes de manière autonome et crée des entrées complètes ; les termes dont la fiabilité est faible sont soumis pour validation à un expert du client. Le traducteur travaille ainsi dès la première ligne avec une terminologie vérifiée (voir le chapitre « TermBoy – l’agent IA de terminologie »).
Une fois que les traducteurs ont terminé leur travail, le texte est vérifié à l’aide de l’outil d’assurance qualité (QA) intégré au système de TAO. L’assurance qualité contrôle les aspects formels de la traduction : ponctuation, nombres et dates et – plus important encore – l’utilisation effective, dans le texte traduit, des termes enregistrés dans la base terminologique. Si le traducteur s’écarte délibérément d’une entrée, il doit valider le message correspondant. Les paramètres de QA sont définis automatiquement par TTN TMS lors de la création du projet, de manière à correspondre aux exigences linguistiques spécifiques du client. En Suisse, ce sont les directives de l’administration fédérale qui s’appliquent, sauf convention contraire.
Un deuxième test, le contrôle IA, vérifie la concordance du contenu entre le texte source et le texte cible. Pour ce faire, l’ensemble du texte est d’abord transmis à un modèle d’IA – en règle générale la version actuelle de ChatGPT ou de Claude – afin que le modèle puisse saisir les liens entre les différentes parties du document. TTN TMS ouvre ensuite le fichier XLIFF bilingue segmenté et envoie chaque paire de phrases individuellement à l’IA en lui demandant si la traduction s’inscrit dans le contexte général et si elle peut être améliorée. Le contrôle IA fournit un tableau indiquant les numéros des segments que le traducteur devrait vérifier. Il s’agit souvent de nuances sans importance ; les erreurs de traduction grossières et les omissions sont toutefois détectées de manière fiable et peuvent être corrigées.
Une fois que le traducteur a effectué les deux contrôles et envoyé les fichiers, ceux-ci sont automatiquement acheminés vers le relecteur. Le système génère à nouveau un contrôle IA et un rapport de QA complet à partir de l’outil de TAO et met les deux à disposition pour soutenir la révision. Une fois que le relecteur a soumis la version révisée, les rapports IA et QA finaux sont établis. Ils peuvent également être consultés par le client et documentent la précision et la cohérence linguistiques du texte avant la livraison. Les deux contrôles sont décrits en détail dans les chapitres « Contrôle de qualité de l’IA » et « Le contrôle IA du point de vue du client ».
Si le client modifie le texte après la traduction, il peut le charger sur le système ou l’envoyer par courriel. Le fichier sera ensuite adapté et les dernières modifications seront mises à jour dans la mémoire de traduction. La mémoire de traduction reste ainsi à jour même lorsque la version définitive a été établie en dehors du système.
Post-édition complète
Dans la post-édition complète, le texte est d’abord traduit par un fournisseur d’IA – DeepL, Claude, ChatGPT ou un autre fournisseur de LLM. La prétraduction passe toujours par l’API de Trados et utilise les mêmes ressources qu’une traduction classique : les correspondances à 100 % et à 99 % de la mémoire de traduction sont reprises telles quelles, les correspondances approximatives sont transmises au fournisseur d’IA à titre d’indication, et les entrées pertinentes de la base terminologique sont insérées segment par segment dans le prompt de traduction (injection terminologique).
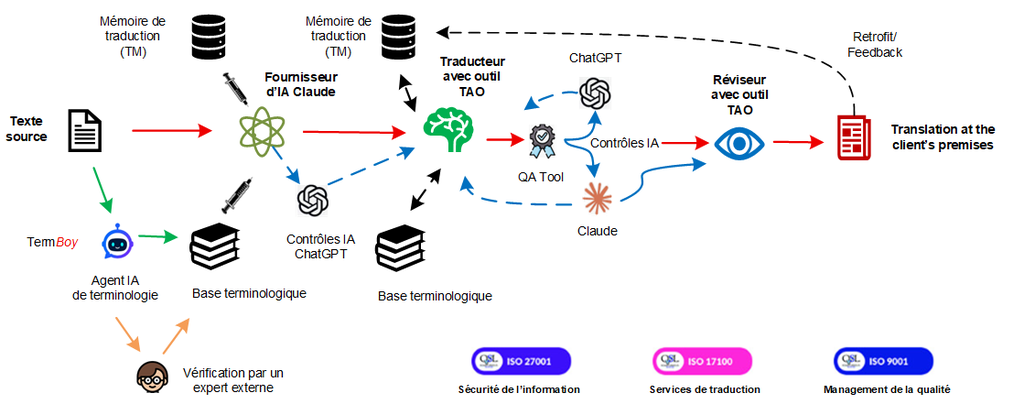
Figure 6 : Flux de travail de la post-édition complète
Un deuxième fournisseur d’IA vérifie ensuite la traduction automatique : si Claude a traduit, ChatGPT contrôle – et inversement. Ce test croisé est appelé contrôle IA-IA. Avec le rapport de QA, le post-éditeur dispose ainsi, avant même de commencer son travail, d’une liste des passages où la traduction automatique est faible.
Le post-éditeur compare soigneusement le texte cible au texte source et le porte au niveau d’une traduction spécialisée humaine. Si le système détecte des images, des références ou d’autres éléments non traités, le responsable de la traduction vérifie les fichiers et les adapte en conséquence avant de les envoyer au client. Le responsable de la traduction vérifie également que le traducteur peut accéder aux ressources pertinentes de la mémoire de traduction et de la base de données terminologique, ce qui garantit que le travail linguistique est effectué avec les bonnes données de référence.
Après la post-édition, le fichier passe par les mêmes contrôles qu’une traduction classique : rapport de QA et contrôle IA. Le responsable de la traduction valide la traduction et la livre ; les modifications ultérieures apportées par le client sont réintégrées dans la mémoire de traduction via Retrofit.
Post-édition légère
La post-édition légère fonctionne de la même manière que la post-édition complète, mais sans l’étape de révision. Le post-éditeur se concentre essentiellement sur le texte cible et ne consulte le texte source qu’en cas de problème apparent dans le texte traduit mécaniquement.
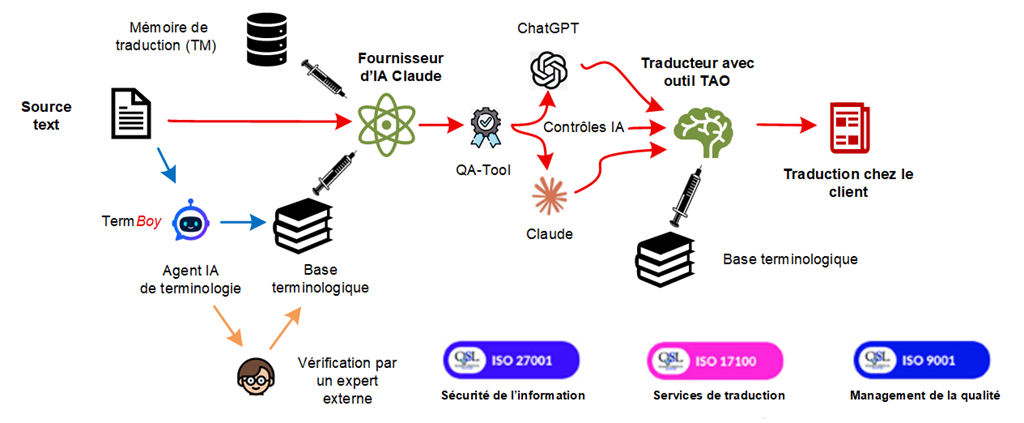
Figure 7 : Flux de travail de la post-édition légère
Ici aussi, le post-éditeur dispose du rapport de QA et du contrôle IA du deuxième fournisseur d’IA, ce qui lui permet de concentrer son attention sur les segments signalés. Comme pour la post-édition complète, la terminologie et les correspondances de la mémoire de traduction ont déjà été intégrées dans la prétraduction.
Si le traducteur ne saisit pas « Hold » ou « Check » dans la fenêtre qui s’affiche lorsqu’il clique sur « Archiver », la traduction est transmise automatiquement au client. Ce modèle convient aux textes pour lesquels l’intelligibilité et la rapidité priment et où aucune formulation prête à la publication n’est exigée.
Traduction automatique
Le modèle de traduction automatique est le plus simple. Il envoie le texte à ChatGPT, Claude, DeepL ou tout autre fournisseur LLM bien connu qui traduit le texte. La traduction est toujours effectuée à l’aide de l’API de Trados. Il synchronise la terminologie dans la base de données terminologique, insère les termes correspondants dans le prompt et demande au fournisseur de traduction d’appliquer des correspondances approximatives. Les correspondances complètes sont toujours traduites de la même manière, sans modification.
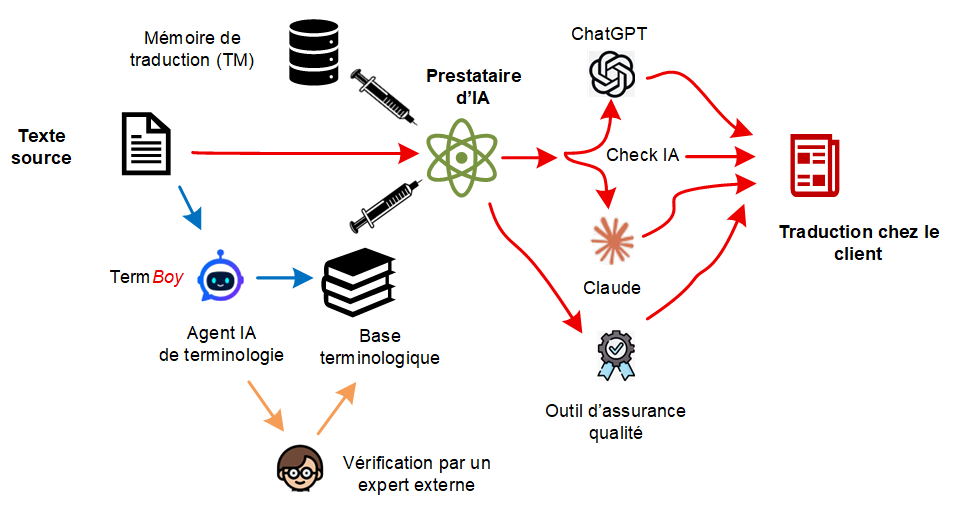
Figure 8 : Traduction automatique – le contrôle IA est transmis au client.
La traduction automatique via TTN est particulièrement utile lorsque le client ou son organisation dispose d’importantes mémoires de traduction et que la terminologie est bien définie dans la base terminologique, car les processus de prise en compte de la terminologie prennent en considération les traductions existantes et les termes approuvés. Cela permet au système de produire des résultats plus cohérents avec le langage établi par le client.
Comme ce modèle ne prévoit aucune post-édition humaine, le contrôle de la qualité est transmis directement au client : le contrôle IA du deuxième fournisseur et le rapport de QA sont livrés avec la traduction. Tous deux sont joints sous forme de fichier HTML et sont en outre disponibles dans les détails de la commande, dans la gestion des commandes.
Le client voit ainsi, segment par segment, les passages signalés par l’IA de contrôle et décide lui-même s’il utilise le texte tel quel, s’il fait réviser certains passages ou s’il transforme la commande a posteriori en post-édition. La traduction automatique reste ainsi traçable et documentée, même sans révision humaine.
Archives de traduction
Les clients de TTN TMS sont membres de différents groupes d’utilisateurs. L’un des groupes les plus importants est celui des archives. Un membre d’un groupe d’archives peut voir et télécharger les traductions des autres membres de ce groupe. En général, une entreprise dispose de différents groupes d’archives. Il n’est pas souhaitable que les textes du département RH soient accessibles à tous les autres utilisateurs. Toutefois, les traductions du service de presse et des médias peuvent être consultées et téléchargées par tous les membres.
TTN conserve des archives en texte intégral pour tous les textes sources et cibles. Par conséquent, tous les fichiers sont convertis en fichiers HTML.

Figure 9 : Recherche plein texte dans les archives de traduction
La recherche dans les archives permet une recherche différenciée par termes, langues, format et autres critères.

Figure 10 : Une liste à trois niveaux permet d’accéder rapidement et facilement aux résultats de recherche souhaités.
L’archive présente les résultats dans une liste à trois niveaux, ce qui facilite l’accès rapide aux commandes terminées ou en cours. Toutes les informations relatives à la commande, y compris les fichiers de documentation, les instructions ou les fichiers XLIFF, peuvent être trouvées en quelques clics.

Figure 11 : Archives de traduction avec images en HTML dans le navigateur
Comme tous les fichiers sont convertis en HTML, le contenu peut être affiché directement dans le navigateur et téléchargé. L’intégration d’images, de graphiques et de schémas permet de se repérer rapidement dans le texte.
Grâce à la conversion en HTML et à l’indexation plein texte, l’utilisateur peut rechercher et accéder très rapidement à toutes les traductions actuelles et réalisées.

Figure 12 : Une visionneuse côte à côte permet d’analyser les textes source et cible.
Les archives juxtaposées permettent aux traducteurs et aux clients de localiser et d’identifier très rapidement les chaînes de recherche et les anciennes traductions.

Figure 13 : Les utilisateurs peuvent accéder aux mémoires de traduction et y effectuer des recherches sans logiciel tiers.
TTN TMS s’intègre parfaitement au serveur GroupShare, offrant aux utilisateurs autorisés un accès direct au contenu de la mémoire de traduction. En fonction de leurs autorisations, les utilisateurs peuvent télécharger des données de la mémoire de traduction au format TMX sans avoir besoin d’accéder directement à GroupShare.
La même fonctionnalité s’applique aux bases de données terminologiques : les utilisateurs peuvent consulter et récupérer le contenu des bases de données terminologiques par l’intermédiaire du système TTN TMS ou de l’interface multilingue en ligne, ce qui garantit un accès transparent et efficace à toutes les ressources linguistiques.

Figure 14 : Base de données en ligne MultiTerm
La base de données MultiTerm et ses entrées sont très importantes pour les traductions automatiques, car les termes sont exportés vers DeepL et d’autres fournisseurs. Le client peut ajouter des termes et en rechercher directement dans sa base de données. Un lien vers la base de données est ajouté dans le courriel de livraison, ce qui permet d’influer sur la prochaine traduction.
L’accès direct aux mémoires de traduction et aux bases de données terminologiques garantit une transparence totale des ressources de traduction. Le client peut vérifier à tout moment si elles sont correctement gérées, ce qui renforce la confiance dans le processus global.
Accès à la base de données des traducteurs
S’il configure cette option, le client peut obtenir un lien vers la base de données des traducteurs, où il peut accéder au profil des traducteurs et des relecteurs.

Figure 15 : Accès au profil du traducteur et du relecteur
Le système peut être paramétré pour insérer dans chaque rapport de livraison de traduction un lien vers la base de données des traducteurs, où le client peut récupérer des informations sur son équipe de traduction. Il peut ainsi s’assurer que l’équipe de traduction est qualifiée ou, s’il y est autorisé, limiter l’équipe à ses traducteurs préférés.
Fonctions de feedback
TTN offre de puissantes fonctions de feedback permettant aux clients d’évaluer chaque traduction. Ces notes ont un impact direct sur la sélection de l’équipe de traduction.

Figure 16 : Fonction de feedback du client avec évaluation
Le client peut charger une version révisée. L’ancienne version sera remplacée dans les archives, et le traducteur et le relecteur recevront par courriel un récapitulatif de toutes les modifications. Le nouveau fichier est incorporé dans la mémoire de traduction par la procédure Retrofit qui est expliquée plus loin.
La fonction de retour d’information permet au responsable de la traduction de savoir si le client est satisfait du service. Si le retour d’information n’est pas satisfaisant, il peut changer le traducteur ou l’ensemble de l’équipe.
Statistiques et graphiques
Le système propose des statistiques par langue, par chiffre d’affaires et bien plus encore. Le cas échéant, les factures peuvent être éditées et contrôlées en ligne.

Figure 17 : Graphiques pour le chiffre d’affaires, la demande linguistique, les mots traduits
Un système complexe d’analyse des coûts permet de déterminer si l’équipe et l’ensemble du service travaillent efficacement.
Facturation
Il n’existe pas de système de facturation universellement normalisé pour les services de traduction, ce qui entraîne une grande complexité. Les agences de traduction sont tenues de soumettre des offres, tandis que chaque entreprise définit ses propres procédures de facturation très spécifiques dans le document de spécifications techniques. Ces exigences comprennent souvent des fourchettes de taux de correspondance personnalisées pour les outils de traduction assistée par ordinateur, et des préférences de facturation qui peuvent être basées sur le texte source ou cible, le nombre de mots, le nombre de lignes (avec ou sans espaces), et de nombreux autres indicateurs.
TTN TMS, un système de gestion des traductions développé depuis plus de 30 ans, prend en charge toutes les variantes de facturation connues.
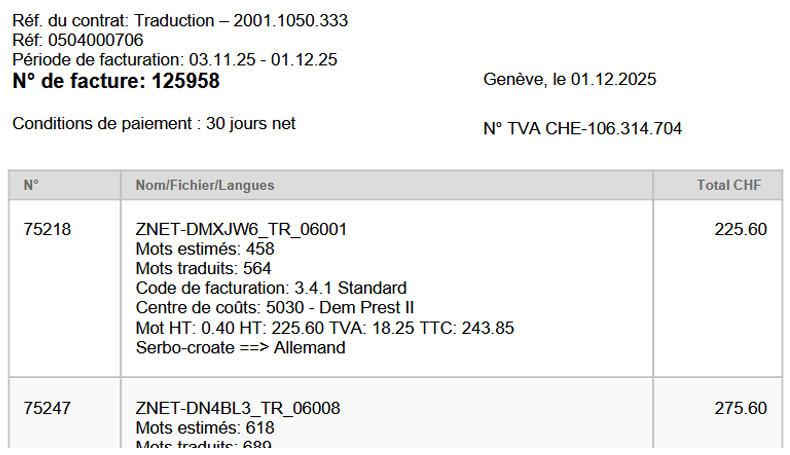
Figure 18 : Extrait d’une facture avec des données spécifiques au client
Les factures sont envoyées par courriel au format PDF. Elles sont également accessibles en ligne, ce qui assure une transparence totale et permet de vérifier le nombre de mots et de confirmer l’exactitude et la conformité des montants facturés. Les factures sont générées dans des formats spécifiques à chaque pays ; en Suisse, par exemple, un code QR est requis conformément aux normes nationales de facturation.