 Deutsch
 Français
 English
Y a-t-il des limites à la taille des bases de données terminologiques ?
Pour les bases de données MultiTerm sur le serveur GroupShare, le nombre maximum d’entrées n’est limité que par la capacité de stockage disponible.
Comment l’accès aux bases de données terminologiques est-il géré ?
TTN TMS fournit des droits d’accès dynamiques qui sont automatiquement accordés et révoqués selon les besoins. Tous les utilisateurs peuvent accéder à MultiTerm en ligne ; cependant, les clients ont généralement des autorisations en lecture seule, tandis que les traducteurs ont des autorisations en lecture/écriture. Les droits d’accès sont vérifiés et attribués automatiquement lorsqu’une commande est attribuée à un traducteur ou à un relecteur.
Est-il possible de modifier la structure de la base terminologique pour une utilisation spéciale ?
Dans la plupart des cas, un glossaire contenant uniquement le terme source et le terme cible est suffisant. Toutefois, dans des domaines spécialisés tels que la traduction médicale, il est souvent essentiel d’ajouter des champs supplémentaires à la base terminologique. Par exemple, un glossaire bilingue simple peut ne contenir que l’entrée « angioplastie – angioplastie » (anglais – français). En ajoutant des champs supplémentaires, la même entrée peut contenir des informations beaucoup plus riches. Un champ Définition peut décrire le concept, par exemple : « Procédure chirurgicale visant à rétablir le flux sanguin dans une artère en gonflant un minuscule ballon. » Un champ Référence ou Source peut indiquer l’origine de cette définition, par exemple « Lignes directrices de l’Organisation mondiale de la santé (2021). » Un champ Contexte peut contenir un exemple d’utilisation typique : « Le patient a subi une angioplastie pour ouvrir l’artère obstruée. »
Grâce à ces champs, les traducteurs voient immédiatement la signification précise du terme. La définition explique le concept dans un langage clair, ce qui est crucial dans les cas pouvant être ambigus. Le champ de référence renvoie à une source ou à une norme faisant autorité, ce qui renforce la confiance dans l’information. Cela réduit le risque d’erreurs et permet de s’assurer que tous les traducteurs utilisent le terme de manière cohérente.
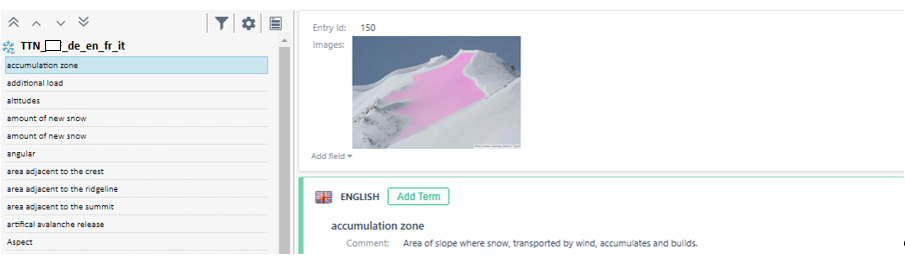
Figure 1 : Termes avec commentaire et image
Dans d’autres disciplines, comme la météorologie, une image d’un type de nuage spécifique peut être utile, tandis qu’en nivologie, une image d’une avalanche ou d’un type de neige particulier peut être précieuse. Toutes ces fonctionnalités sont entièrement prises en charge par MultiTerm. Des champs tels que Source, Notes, Définition, Référence, Contexte ou Image peuvent être ajoutés à la définition de la base terminologique, marqués comme obligatoires via un modèle d’entrée, et rendus visibles et exploitables dans l’interface utilisateur. Ils peuvent être affichés dans des présentations personnalisées et utilisés pour le filtrage et la recherche par tous les utilisateurs autorisés qui travaillent avec la base de données terminologique basée sur le serveur.
Comment s’effectue la recherche dans les bases terminologiques ?
Pour la gestion terminologique, Trados GroupShare (via le serveur MultiTerm) répond également à toutes les exigences de recherche. Le système propose à la fois la recherche de termes exacts et la recherche de termes flous dans les bases de données terminologiques, ce qui permet de trouver des entrées soit par des correspondances exactes, soit par des termes présentant de légères variations d’orthographe ou de formulation. La recherche MultiTerm peut être configurée pour retrouver des termes même si la requête ne correspond pas exactement, en utilisant une correspondance approximative pour identifier les termes similaires et les renvoyer avec un score de pertinence. Cela garantit qu’aucun terme pertinent n’est oublié, même si la requête contient des différences mineures ou des fautes de frappe.
Tous les champs définis d’une entrée de terme sont affichés dans le cadre des résultats de la recherche ou lors de la consultation d’une entrée, y compris tous les champs obligatoires tels que le terme, la traduction, la définition, la phrase de contexte et la note d’utilisation.
Comment les entrées terminologiques sont-elles détectées et affichées ?
Les termes des bases terminologiques connectées sont automatiquement reconnus et clairement marqués dans le segment source dans l’environnement de traduction. Le traducteur peut ainsi accéder immédiatement à l’entrée complète de chaque terme et visualiser toutes les informations requises en un coup d’œil. La composante terminologique du système fournit un support complet pour la détection de la terminologie grâce à des fonctions dont voici quelques exemples :
- Détection automatique des termes : Les termes stockés dans la base terminologique sont automatiquement identifiés lorsqu’ils apparaissent dans le segment source.
- Mise en évidence visuelle des termes : Chaque terme détecté est clairement marqué (surligné) dans le texte source pour une meilleure visibilité par le traducteur.
- Accès à la saisie rapide de termes : Les utilisateurs peuvent rapidement accéder à l’entrée complète de la base terminologique pour tout terme mis en évidence directement à partir de l’interface (par exemple, en survolant ou en sélectionnant le terme), révélant immédiatement tous les détails associés au terme.
- Visibilité de tous les champs : Tous les champs obligatoires et personnalisés liés à chaque terme (tels que les références de source, les définitions et les notes d’utilisation) sont affichés dans le cadre des informations de saisie du terme, ce qui permet à l’utilisateur de visualiser toutes les données pertinentes relatives au terme dans l’environnement.
Comment les bases de données terminologiques sont-elles gérées ?
Le système de gestion des traductions offre des fonctionnalités complètes pour la gestion des mémoires de traduction et des bases terminologiques. Il combine des processus automatisés avec le contrôle de l’administrateur pour assurer une gestion efficace et flexible des ressources. Les principaux aspects sont les suivants :
Le système gère automatiquement la mémoire de traduction et la configuration de la base terminologique en fonction des paires de langues du projet. Lorsqu’un projet implique une combinaison de langues source et cible précédemment inutilisée, le système génère une nouvelle base terminologique à l’aide de modèles et de paramètres prédéfinis.
Comment les gestionnaires de traduction contrôlent-ils les bases terminologiques ?
Les administrateurs ou les responsables de la traduction ont un contrôle total sur toutes les bases de données terminologiques. Ils peuvent créer, modifier ou supprimer manuellement des mémoires de traduction et des bases terminologiques et adapter leur structure (par exemple, en ajoutant ou en modifiant des champs et des métadonnées) et leur contenu. Le système permet également d’importer et d’exporter des données de mémoires de traduction ou de bases terminologiques à des fins de sauvegarde, de migration ou d’intégration, ce qui confère à l’organisation une certaine souplesse dans la gestion des ressources linguistiques.
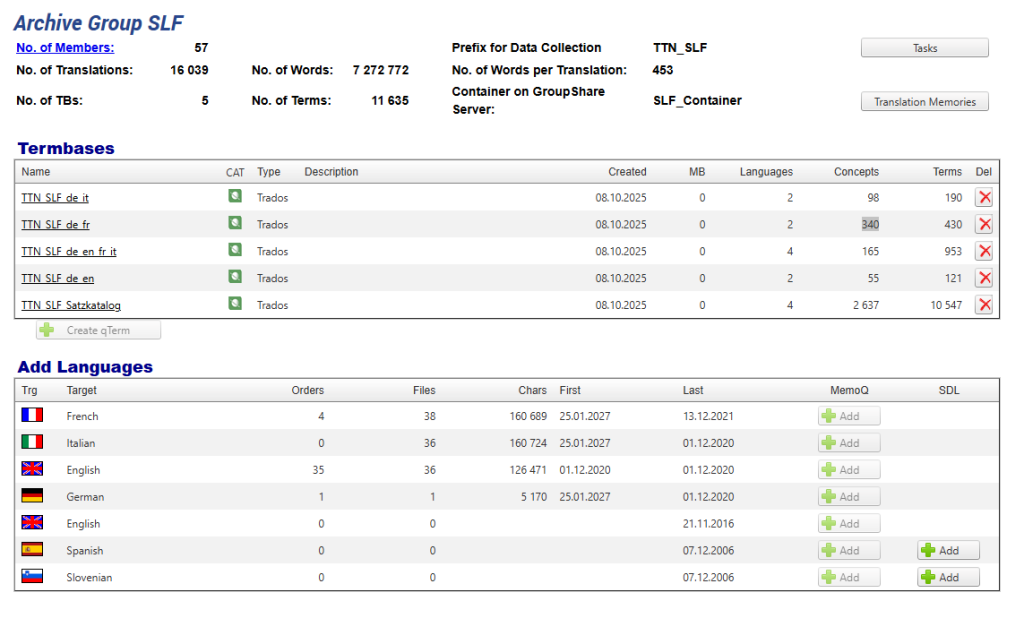
Figure 2 : Créer manuellement une base terminologique avec TTN TMS sur la base d’un modèle prédéfini.
Comment les bases de données terminologiques sont-elles personnalisées ?
Par défaut, le système utilise une configuration terminologique standard de base pour les nouvelles paires de langues et ne crée automatiquement une base terminologique que s’il n’en existe pas pour les langues source-cible requises. Si une base terminologique spécialisée est nécessaire (par exemple avec des champs personnalisés ou des structures de termes complexes), un responsable de la traduction peut la créer ou l’adapter à l’aide d’un outil de gestion terminologique externe (par exemple, une application Trados MultiTerm ou un module terminologique GroupShare). Cette méthode manuelle est plus complexe et n’est généralement utilisée que lorsque la configuration par défaut de la base terminologique ne répond pas à des exigences spécifiques.
En résumé, le système gère automatiquement la mémoire de traduction et la base terminologique en créant ou en réutilisant les ressources utiles pour les nouvelles combinaisons de langues, tout en permettant aux administrateurs d’effectuer un contrôle détaillé et une personnalisation si nécessaire. Les entreprises clientes bénéficient ainsi à la fois de l’efficacité grâce à l’automatisation et de la flexibilité grâce au contrôle de l’administrateur dans la gestion des mémoires de traduction et bases terminologiques.