 Deutsch
 Français
 English
Y a-t-il des limites à la taille des mémoires de traduction ou des bases terminologiques ?
Le nombre de segments dans une mémoire de traduction n’est limité que par l’espace de stockage disponible, qui peut être étendu de manière dynamique.
Comment l’accès aux mémoires de traduction est-il géré ?
TTN TMS fournit des droits d’accès dynamiques qui sont automatiquement accordés et révoqués selon les besoins. Tous les utilisateurs peuvent accéder à MultiTerm en ligne ; cependant, les clients ont généralement des autorisations en lecture seule, tandis que les traducteurs ont des autorisations en lecture/écriture. Les droits d’accès sont vérifiés et attribués automatiquement lorsqu’une commande est attribuée à un traducteur ou à un relecteur.
Est-il possible d’adapter les champs des mémoires de traduction à un usage particulier ?
Dans les traductions juridiques ou techniques, telles que les normes de construction, il est souvent utile d’ajouter des champs personnalisés, par exemple un numéro de référence ou un lien vers l’article ou la norme en question. Dans ce cas, la structure de la mémoire de traduction doit être complétée par des champs personnalisés obligatoires.
Trados GroupShare prend en charge les mémoires de traduction avec des métadonnées enrichies. Chaque entrée de la mémoire de traduction contient le segment source, le segment cible et un nombre quelconque de champs personnalisés définis selon les besoins spécifiques. Ces champs personnalisés sont entièrement pris en charge par l’interface et les API de GroupShare : ils peuvent être créés à l’aide de modèles de champs, visualisés et modifiés dans l’éditeur de mémoire de traduction, et utilisés comme paramètres de filtrage ou de recherche.
Comment s’effectue la recherche dans les mémoires de traduction ?
Comment les recherches par « correspondance exacte » et « correspondance approximative » sont-elles gérées et comment s’assure-t-on que la recherche fonctionne correctement dans toutes les langues ?
Le composant de mémoire de traduction basé sur le serveur Trados GroupShare prend entièrement en charge les modes de recherche par correspondance exacte et par correspondance floue pour la recherche de segments. La recherche par correspondance exacte ne permet de retrouver que les segments source identiques à 100 %, tandis que la recherche par correspondance floue renvoie les segments similaires accompagnés d’un score de similarité. Le moteur de recherche de la mémoire de traduction utilise des algorithmes de correspondance approximative robustes pour calculer les pourcentages de correspondance, indiquant dans quelle mesure un nouveau segment correspond à une unité de traduction existante. Cela garantit des résultats de recherche complets et précis, car même les correspondances partielles sont identifiées et présentées avec leur score de pertinence.
Tous les champs obligatoires et les métadonnées associés à chaque unité de traduction sont disponibles dans les résultats de recherche de la mémoire de traduction. Chaque résultat affiche le segment source et le segment cible ainsi que les champs de métadonnées requis, y compris les champs personnalisés marqués comme obligatoires et les champs standard du système tels que la date de création ou l’auteur. Les mêmes mécanismes de recherche s’appliquent à toutes les langues prises en charge par le système, ce qui garantit un comportement cohérent pour les contenus multilingues.
Comment TTN TMS détecte-t-il les segments déjà traduits ?
TTN TMS détecte automatiquement les segments déjà traduits et les propose pour être réutilisés chaque fois qu’un segment source correspondant est ouvert. Le système trouve des correspondances exactes et approximatives dans la mémoire de traduction, présente chaque suggestion avec des détails contextuels et met en évidence les différences pour les correspondances partielles, ce qui permet au traducteur de choisir et d’insérer facilement la traduction préférée, qui est clairement identifiée comme provenant de la mémoire de traduction.
- Insertion automatique des correspondances : Le système proposé détecte automatiquement tous les segments déjà traduits dans la mémoire de traduction (à la fois les correspondances exactes à 100 % et les correspondances partielles approximatives). Lorsqu’un traducteur ouvre un nouveau segment source, la mémoire de traduction est consultée et la meilleure traduction correspondante est immédiatement insérée dans le segment cible. Cela permet aux traducteurs de réutiliser les traductions existantes dans la mesure du possible, sans qu’il soit nécessaire d’effectuer une recherche manuelle pour chaque segment.
- Recherche de correspondances multiples : Si plus d’une correspondance est trouvée dans une mémoire de traduction pour un segment source donné, l’interface affiche toutes les correspondances (ainsi que leurs pourcentages de correspondance) comme référence pour l’utilisateur. Le traducteur peut facilement parcourir ces suggestions et choisir celle qu’il souhaite utiliser. Par exemple, le système répertorie les correspondances dans l’onglet Résultats de la traduction et permet à l’utilisateur d’insérer une autre correspondance à la place de celle qui figure en tête de liste. Cela permet à l’utilisateur de choisir la traduction qu’il préfère lorsqu’il existe plusieurs options.
- Visibilité des métadonnées de la correspondance : Pour chaque résultat dans la mémoire de traduction, le système fournit un contexte supplémentaire et des métadonnées sur la correspondance. Le traducteur peut voir des informations telles que la mémoire de traduction d’où provient la correspondance et d’autres attributs tels que le document original ou le nom du fichier s’il est disponible. Ces métadonnées sont affichées à côté de l’entrée de la correspondance, ce qui aide les utilisateurs à évaluer l’origine et la fiabilité de chaque suggestion.
- Surlignage des différences pour les correspondances partielles : Lorsqu’une traduction enregistrée ne correspond que partiellement au nouveau segment source, le système met clairement en évidence toutes les différences entre le texte source et la suggestion de la mémoire de traduction. Les mots ou phrases qui diffèrent sont indiqués dans la comparaison (par exemple, le texte ajouté est souligné dans une couleur et le texte supprimé est barré dans une autre couleur). Le traducteur peut ainsi voir immédiatement quelles modifications sont nécessaires, car les différences sont présentées dans un style « suivi des modifications » pour faciliter l’identification.
- Marquage clair du contenu inséré à partir de la mémoire de traduction : Les segments qui ont été préremplis ou insérés à partir de correspondances de la mémoire de traduction sont marqués clairement dans l’environnement d’édition. Par exemple, une icône ou un badge dans la colonne d’état du segment indique que le contenu provient d’une correspondance de la mémoire de traduction et indique même le pourcentage de correspondance. Les traducteurs et les relecteurs peuvent ainsi instantanément reconnaître quels segments cibles ont été tirés de la mémoire de traduction (avec quel niveau de correspondance), ce qui garantit la transparence. Une fois que le traducteur a édité ou confirmé le segment, l’indicateur est mis à jour en conséquence pour montrer que la traduction a été révisée, tout en conservant les informations de correspondance originales à titre de référence.
Toutes ces fonctionnalités sont entièrement prises en charge par le composant de mémoire de traduction de TTN TMS, ce qui permet d’exploiter efficacement les traductions précédentes tout en offrant aux traducteurs un contrôle intégral et une visibilité totale. Ce mécanisme de correspondances tirées de la mémoire de traduction permet non seulement d’augmenter la productivité en réutilisant les traductions existantes, mais aussi de fournir aux traducteurs des informations et des options claires pour garantir la qualité et la cohérence des traductions.
Comment TTN TMS intègre-t-il la traduction automatique à la mémoire de traduction ?
TTN TMS combine de manière transparente la traduction automatique (TA), la mémoire de traduction et la gestion terminologique dans un flux de travail unifié. Cette approche intégrée permet d’utiliser à la fois des traductions révisées par des humains et des suggestions générées par l’IA. Le résultat est une production de meilleure qualité avec un effort réduit, grâce à une automatisation intelligente qui accélère les projets sans compromettre la précision.
- Suggestions automatiques de la traduction automatique en l’absence de correspondances dans la mémoire de traduction : Lorsqu’un nouveau segment n’a aucune correspondance dans la mémoire de traduction, TTN TMS fournit automatiquement une suggestion de traduction automatique. Cette suggestion peut être insérée directement dans le texte cible ou présentée pour révision, ce qui permet au traducteur de ne pas partir d’une page blanche. Même lorsque la mémoire de traduction ne contient aucune entrée, un premier projet de traduction est toujours disponible, ce qui réduit le travail manuel et permet de gagner du temps.
- Les suggestions de la traduction automatique accompagnent les correspondances de la mémoire de traduction : TTN TMS ne s’appuie pas sur une source unique de suggestions. Lorsqu’une correspondance floue ou exacte avec les mémoires de traduction est disponible, le système peut extraire une suggestion parallèle et l’afficher à côté du résultat de la traduction automatique. Cette présentation côte à côte permet aux linguistes de sélectionner l’option la plus appropriée ou de combiner des éléments des deux propositions. En présentant ensemble les résultats des mémoires de traduction et la traduction automatique, la plateforme améliore la qualité et la flexibilité de la traduction tout en continuant à bénéficier des traductions existantes et des récentes améliorations apportées à la traduction par l’IA.
- Intégration avec des moteurs de traduction automatique personnalisés (Azure, DeepL, etc.) : La solution est indépendante des moteurs et des fournisseurs. TTN TMS s’intègre aux principaux fournisseurs de traduction automatique tels que Microsoft Azure Translator, DeepL, et d’autres services d’intelligence artificielle, y compris les moteurs basés sur la technologie GPT tels que ChatGPT. Les modèles formés sur mesure peuvent également être connectés via l’API. Cette flexibilité permet d’utiliser des moteurs de traduction automatique préférés pour générer des suggestions de meilleure qualité. Au fur et à mesure que de nouvelles technologies de traduction automatique apparaissent, elles peuvent être intégrées de manière transparente, ce qui garantit une adaptabilité à long terme et un accès continu à des capacités de traduction assistée par ordinateur à la pointe de la technologie.
- L’IA conversationnelle pour le contexte et la terminologie : La couche d’IA conversationnelle de TTN ajoute une dimension supplémentaire à la productivité de la traduction. Les systèmes traditionnels de mémoire de traduction et les bases de données terminologiques ont souvent du mal à fonctionner ensemble de manière optimale ; par exemple, une correspondance floue de mémoire de traduction peut ne pas incorporer automatiquement la terminologie approuvée. La couche d’IA conversationnelle basée sur le GPT remédie à cette limitation en combinant intelligemment les correspondances de TM avec la terminologie approuvée dans le contexte, générant ainsi des suggestions de traduction affinées qui respectent à la fois le contexte de la phrase et les contraintes terminologiques.
En tirant parti de l’IA avancée basée sur le GPT au sein de TTN TMS, le système analyse chaque segment ainsi que les fragments des mémoires de traduction pertinents et les termes de glossaire requis pour produire des traductions fluides qui intègrent ces éléments de manière transparente. Le résultat n’est pas une traduction automatique générique, mais une suggestion fondée sur les traductions existantes et la terminologie établie, assemblée par un processus piloté par l’intelligence artificielle qui tient compte des nuances et du contexte. Cette approche est souvent plus performante que les moteurs de TA traditionnels en termes de précision et de cohérence.
La couche d’IA conversationnelle réduit considérablement le besoin de corrections terminologiques répétées ou de retravailler manuellement les correspondances floues. Les traducteurs reçoivent des projets de traduction de haute qualité qui respectent déjà les glossaires et les directives stylistiques, ce qui réduit les efforts de post-édition. Dans l’ensemble, l’intégration des mémoires de traduction et de la traduction automatique dans TTN TMS, améliorée par une couche d’intelligence artificielle, permet d’obtenir des traductions cohérentes et conformes à la terminologie dès le départ, tout en accélérant les délais de livraison.
Comment les mémoires de traduction sont-elles gérées ?
Le système de gestion des traductions offre des fonctionnalités complètes pour la gestion des mémoires de traduction et des bases terminologiques. Il combine des processus automatisés avec le contrôle de l’administrateur pour assurer une gestion efficace et flexible des ressources. Les principaux aspects sont les suivants :
Le système gère automatiquement la mémoire de traduction et la configuration de la base terminologique en fonction des paires de langues du projet. Lorsqu’un projet implique une combinaison de langues source et cible précédemment inutilisée, le système génère une nouvelle mémoire de traduction et une nouvelle base terminologique à l’aide de modèles et de paramètres prédéfinis, garantissant ainsi une ressource dédiée à cette paire de langues. S’il existe déjà une mémoire de traduction ou une base terminologique appropriée couvrant la paire de langues requise, le système réutilise la ressource existante au lieu de créer un doublon.
Comment les gestionnaires contrôlent-ils les bases terminologiques ?
Les administrateurs ou les responsables de la traduction ont un contrôle total sur toutes les mémoires de traduction et les bases terminologiques. Ils peuvent créer, modifier ou supprimer manuellement des mémoires de traduction et des bases terminologiques et adapter leur structure (par exemple, en ajoutant ou en modifiant des champs et des métadonnées) et leur contenu. Le système permet également d’importer et d’exporter des données de mémoires de traduction ou de bases terminologiques à des fins de sauvegarde, de migration ou d’intégration, ce qui confère une certaine souplesse dans la gestion des ressources linguistiques.
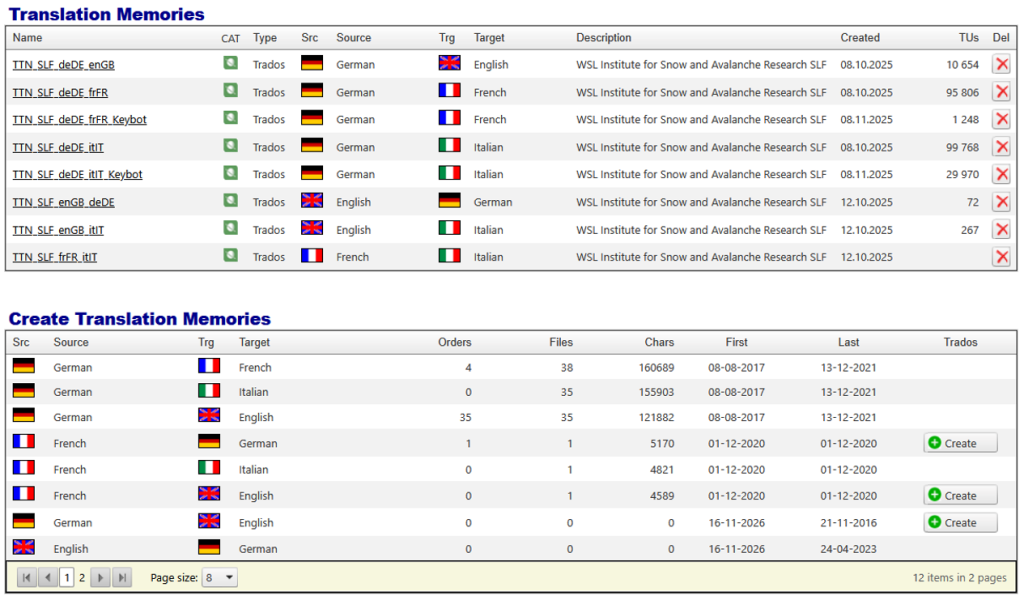
Figure 1 : Créer manuellement une mémoire de traduction avec TTN TMS sur la base d’un modèle prédéfini.
Ajustements structurels via GroupShare : Si une mémoire de traduction nécessite des modifications structurelles avancées au-delà du modèle par défaut (par exemple, l’ajout de champs personnalisés), un responsable de la traduction ou un opérateur système peut se connecter directement au serveur de mémoire de traduction sous-jacent (par exemple, un serveur SDL Trados GroupShare) pour appliquer ces modifications. Cette approche garantit que des configurations spécialisées peuvent être mises en œuvre, même si elles nécessitent l’utilisation d’outils autres que l’interface web par défaut.
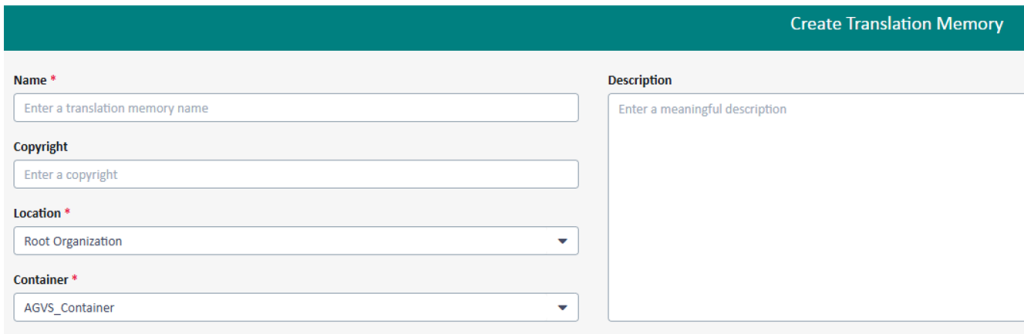
Figure 2 : Créer une TM avec un champ spécial directement sur le serveur GroupShare.
En résumé, le système gère automatiquement la mémoire de traduction et la base terminologique en créant ou en réutilisant les ressources nécessaires pour les nouvelles combinaisons de langues, tout en permettant aux administrateurs d’effectuer un contrôle détaillé et une personnalisation si nécessaire. Les entreprises clientes bénéficient ainsi à la fois de l’efficacité grâce à l’automatisation et de la flexibilité grâce au contrôle de l’administrateur dans la gestion des mémoires de traduction et bases terminologiques.
Dans un environnement TTN TMS intégrant SDL Trados GroupShare, les segments de traduction et les entrées terminologiques enregistrés par un utilisateur dans une mémoire de traduction ou une base terminologique partagée sont immédiatement accessibles aux autres utilisateurs autorisés. GroupShare est une solution de collaboration sur serveur qui centralise les mémoires de traduction et les bases terminologiques. Lorsqu’un membre de l’équipe confirme un segment ou ajoute un terme, la mise à jour est appliquée instantanément pour tous les utilisateurs disposant des droits d’accès appropriés. Ainsi, les traductions et la terminologie les plus récentes sont disponibles sans délai au sein de l’équipe, ce qui permet une collaboration en temps réel.
GroupShare y parvient grâce à la centralisation de sa mémoire de traduction et de sa base terminologique. Dès qu’un traducteur enregistre une nouvelle unité de traduction ou un nouveau terme, l’information est stockée sur le serveur et peut être récupérée immédiatement par d’autres. Par exemple, si un traducteur confirme une nouvelle traduction pour un segment, tout collègue qui consultera ultérieurement le même texte source verra immédiatement que la traduction correspond à 100 % à celle de la mémoire de traduction. De même, si un utilisateur ajoute un terme à la base terminologique partagée, les autres utilisateurs le verront apparaître instantanément comme un terme reconnu dans leur outil de traduction. Cette synchronisation immédiate garantit que tous les membres de l’équipe travaillent toujours avec les traductions les plus récentes et la terminologie convenue.
En fournissant des mises à jour en temps réel des mémoires de traduction et des bases terminologiques partagées, GroupShare contribue à préserver la cohérence et à faciliter le travail d’équipe. Tous les utilisateurs travaillent effectivement avec le même ensemble de traductions et de termes approuvés actualisé dans un environnement sécurisé et uniforme. Cela permet non seulement d’améliorer la cohérence et la qualité globales des traductions, mais aussi de rendre la collaboration entre les traducteurs et les relecteurs beaucoup plus efficace, puisque chacun utilise les segments et la terminologie confirmés les plus récents.