 Deutsch
 Français
 English
Traduction avec les principaux services de traduction utilisant l’IA
TTN TMS propose trois niveaux de traduction automatique dans son flux de travail :
- Post-édition complète
- Post-édition légère
- Traduction entièrement automatique
Les fichiers sont systématiquement traduits par plusieurs fournisseurs de services de traduction par l’IA.
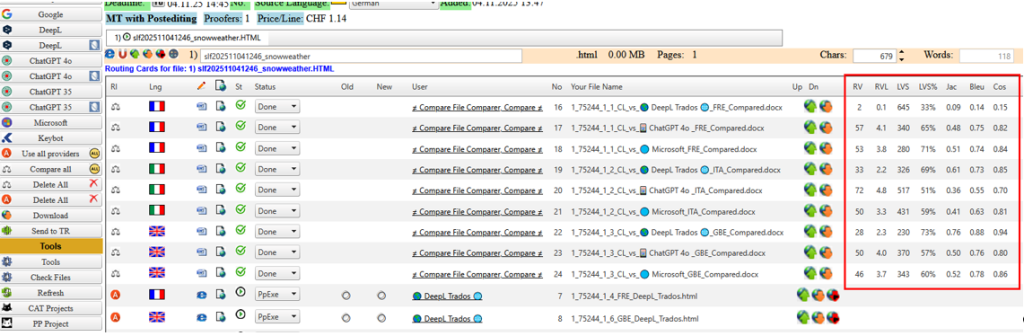
Figure 1 : Traduction parallèle à l’aide des principaux services de traduction par IA
Les résultats traduits sont comparés les uns aux autres et le système produit plusieurs indicateurs comparatifs pour évaluer quel fournisseur est le plus performant. Les traductions automatiques sont exécutées avec et sans mémoires de traduction et bases terminologiques. Cela permet d’évaluer la qualité de chaque fournisseur de traduction et de déterminer quel LLM (large language model) fonctionne le mieux. Il est aussi possible de déterminer la valeur ajoutée des données fournies par GroupShare. Enfin, cette approche permet même de voir si un traducteur a effectué la traduction lui-même ou s’il a utilisé un outil d’intelligence artificielle. Chaque fournisseur d’IA a son propre « ADN » ou sa propre signature linguistique, qui est très difficile à éliminer ; il est presque impossible pour un traducteur humain de reproduire exactement la même formulation.
TTN TMS peut intégrer de nombreux grands modèles linguistiques (LLM) et moteurs de traduction automatique. Il exécute des centaines de tests et calcule divers indicateurs comparatifs, tels que le nombre de révisions, les révisions par ligne, la distance de Levenshtein, l’indice de Jaccard, le score BLEU et l’indice de similarité cosinus. Il classe ensuite les résultats en fonction de leur qualité. Les résultats montrent clairement que les traductions IA s’améliorent considérablement lorsqu’elles sont générées à l’aide d’une mémoire de traduction et d’une base de données terminologique.
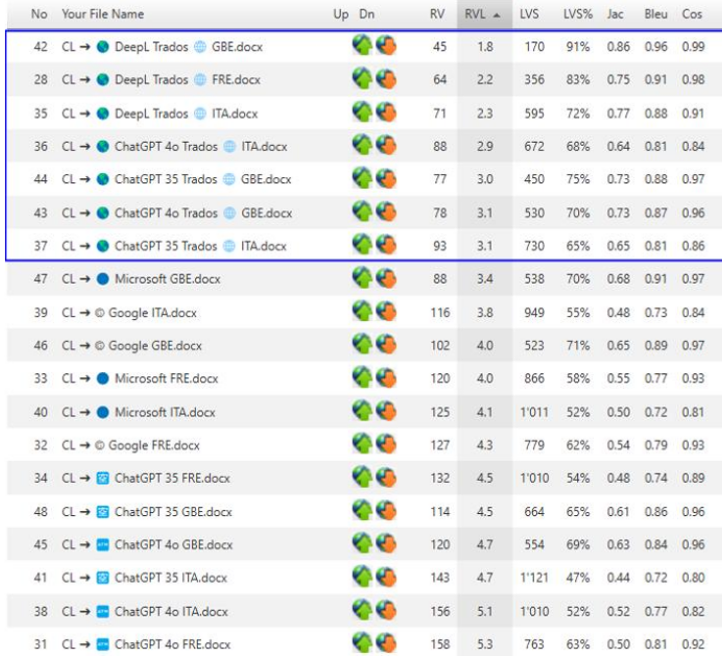
Figure 2 : Fournisseurs de traduction automatique classés selon plusieurs indicateurs de comparaison
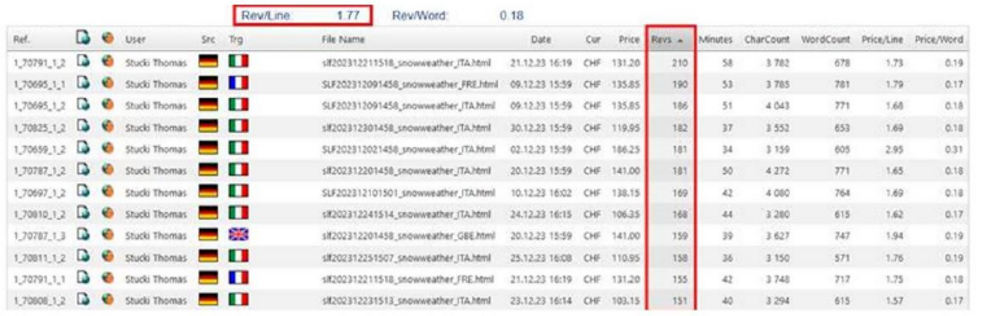
Figure 3 : Évaluation continue de la qualité par rapport à la traduction humaine
TTN TMS suit le nombre de modifications apportées par le relecteur humain et mesure le temps nécessaire par rapport à une traduction traditionnelle.
Extraction de termes
L’outil d’extraction de termes est un élément important du système ; il est utile non seulement pour les traducteurs traditionnels, mais aussi pour produire des traductions d’IA tenant compte de la terminologie. TTN TMS permet aux utilisateurs d’extraire des termes à partir de mémoires de traduction, de sites Web ou de grands dépôts de fichiers. Le traducteur ou le responsable de la traduction peut choisir parmi une grande variété d’outils d’extraction qui suggèrent des candidats à la traduction à partir de corpus parallèles.
TTN TMS intègre une série de moteurs et de services d’extraction, notamment :
- Rainbow Term Extraction
- TBXTools
- tm2tb (Translation Memory to Termbase)
Des corpus parallèles plus petits peuvent également être extraits à l’aide de ChatGPT 5.0. Il peut se connecter à Azure Cognitive Services – Key Phrase Extraction, une solution de Microsoft basée sur le cloud et accessible via un kit de développement logiciel C#. Il s’agit d’un service commercial. TTN TMS intègre des paquets NuGet pour Stanford CoreNLP afin de permettre l’étiquetage POS (part-of-speech) et d’utiliser des modèles pré-entraînés. Stanford CoreNLP est livré avec des modèles de segmentation pré-entraînés pour le chinois et l’arabe.
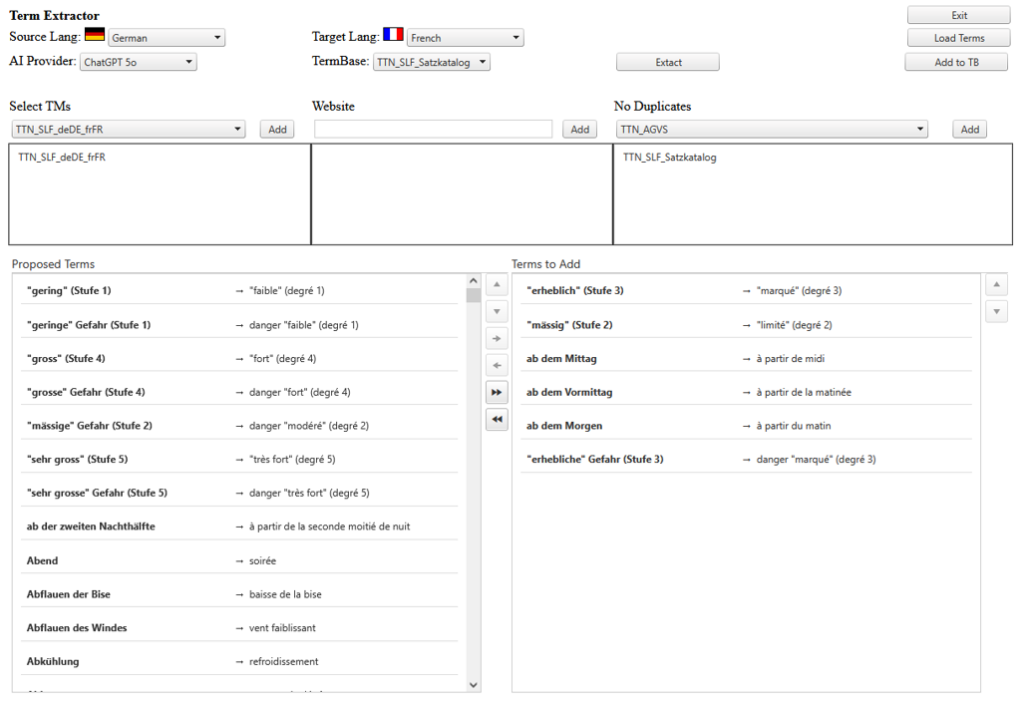
Figure 4 : Extracteur de termes avec des propositions de termes à ajouter à la base de données MultiTerm
Les utilisateurs peuvent passer en revue les candidats classés, filtrer par fréquence, longueur et domaine, et faire glisser les termes de la liste proposée à la liste finale ou les accepter tous en une seule action. Les entrées approuvées sont normalisées (par exemple, la morphologie), dédupliquées et écrites directement dans la base terminologique MultiTerm.
L’extracteur de termes accélère l’intégration des nouveaux linguistes, améliore la cohérence entre les projets et réduit le travail d’ajustement en imposant une terminologie approuvée à la source. En réinjectant les termes validés dans les mémoires de traduction et les pipelines d’IA, le système optimise les résultats de la traduction automatique et améliore la qualité globale de la traduction. La curation centralisée renforce la gouvernance terminologique, assure la traçabilité et permet une réutilisation rapide des termes spécifiques à un domaine entre les paires de langues et les programmes.
Synchronisation de la terminologie avec les fournisseurs d’IA
La terminologie (par exemple, les glossaires DeepL) est automatiquement synchronisée. Après synchronisation, la traduction automatique obtient un bien meilleur résultat.
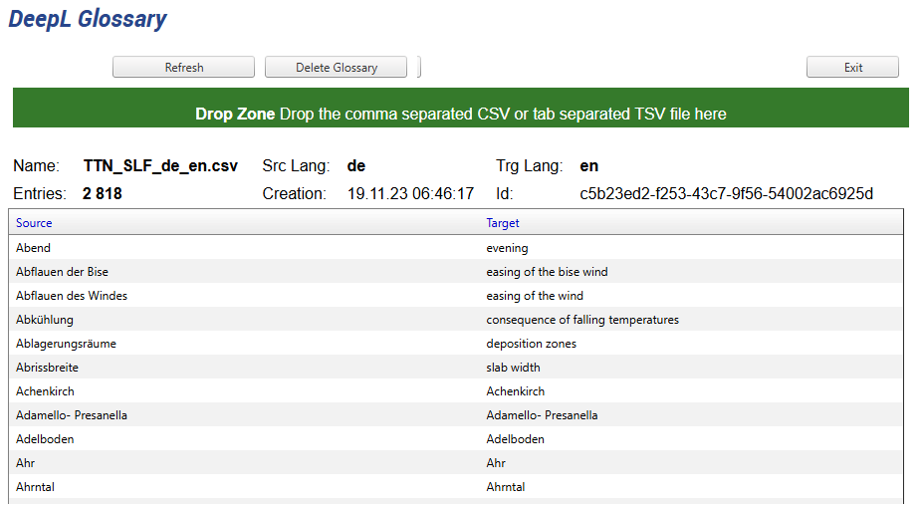
Figure 5 : Synchronisation automatique entre MultiTerm et le glossaire DeepL
L’utilisateur peut superviser le processus de synchronisation et supprimer tout nouveau glossaire sur DeepL, mais aucune intervention humaine n’est généralement nécessaire.
Web-to-TM
En 2006, TTN TMS a lancé son propre moteur de recherche de traduction appelé Keybot. Cet outil parcourt le web de manière extrêmement rapide pour recueillir du contenu multilingue, en créant une base de données parallèle pour chaque domaine multilingue qu’il rencontre. Il peut également traiter de grandes collections de documents en alignant des fichiers bilingues, générant ainsi de vastes corpus parallèles à partir des traductions existantes.
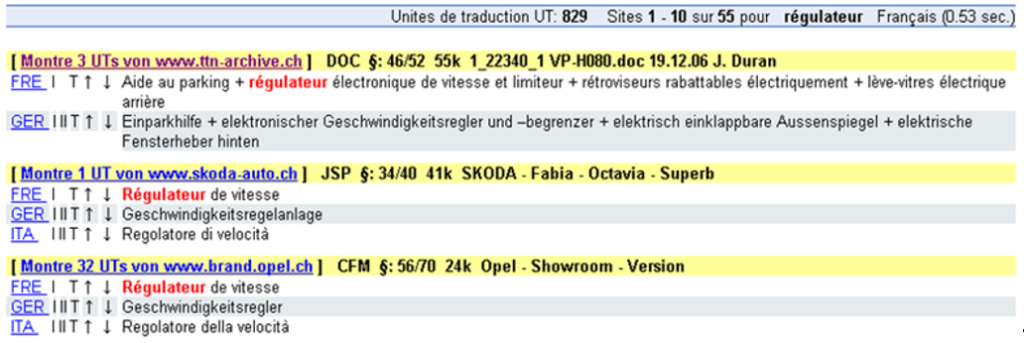
Figure 6 : Corpus parallèles spécifiques à chaque client pour chaque site web client
Le moteur de recherche Keybot détecte les différences subtiles de terminologie entre les sites web des clients, ce qui renforce la confiance dans le système de TTN. Lorsqu’un client commence à travailler avec TTN, le système reconnaît déjà les formulations spécifiques au client, qui peuvent être immédiatement réutilisées en convertissant les corpus parallèles existants en mémoires de traduction sur le serveur GroupShare.
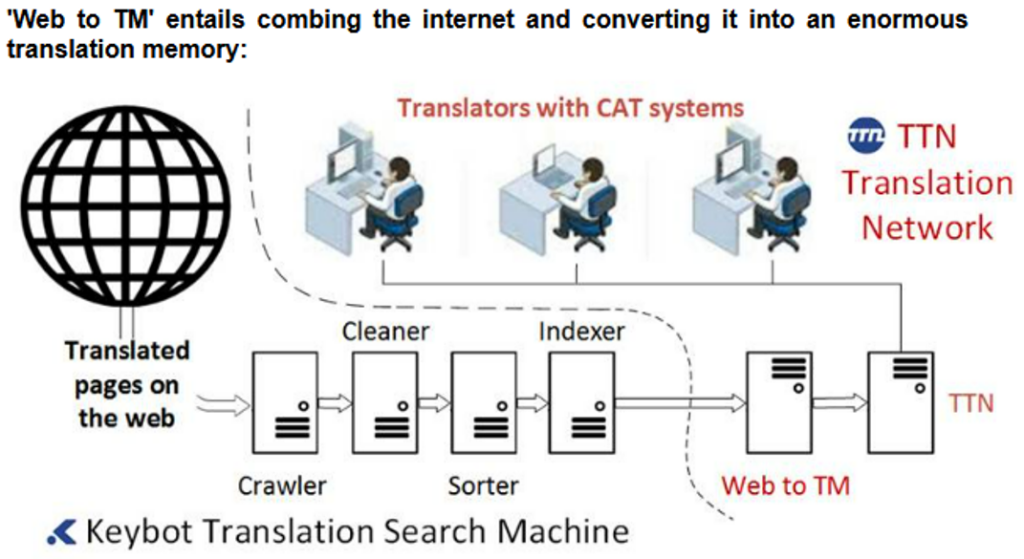
Figure 7 : Web-to-TM convertit des sites web entiers en mémoires de traduction.
Pour trouver des sites web traduits, Keybot utilise des robots d’indexation très performants qui parcourent les sites et en extraient le texte traduit. Le système associe automatiquement le contenu de la langue source et de la langue cible, convertissant des pages entières en vastes corpus parallèles. Ces robots identifient efficacement les textes correspondants dans toutes les langues, garantissant ainsi qu’aucun segment traduit n’est oublié.
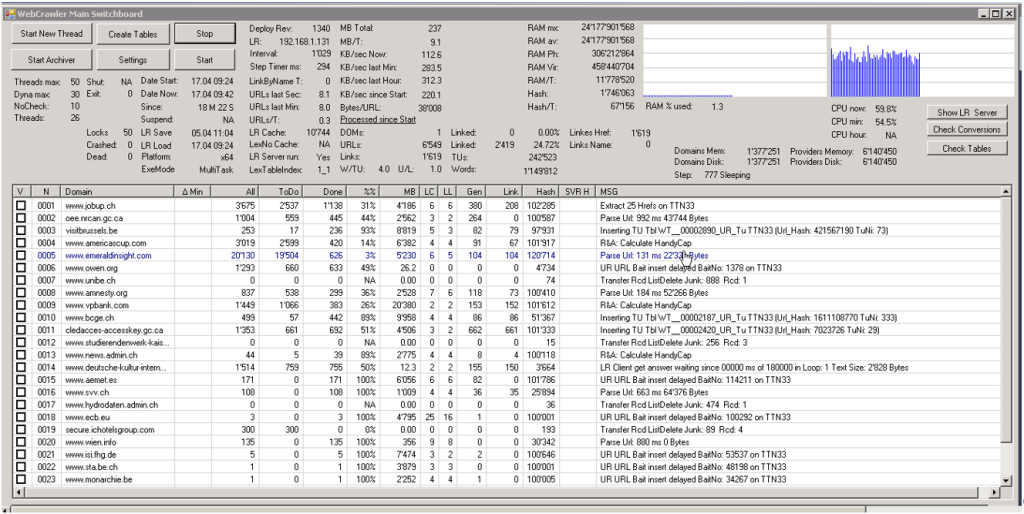
Figure 8 : Des robots d’indexation très performants extraient le texte traduit du web.
Le robot d’indexation du web conserve un corpus parallèle distinct pour chaque domaine qu’il analyse, ce qui lui permet de capturer l’intégralité du contenu bilingue du site.
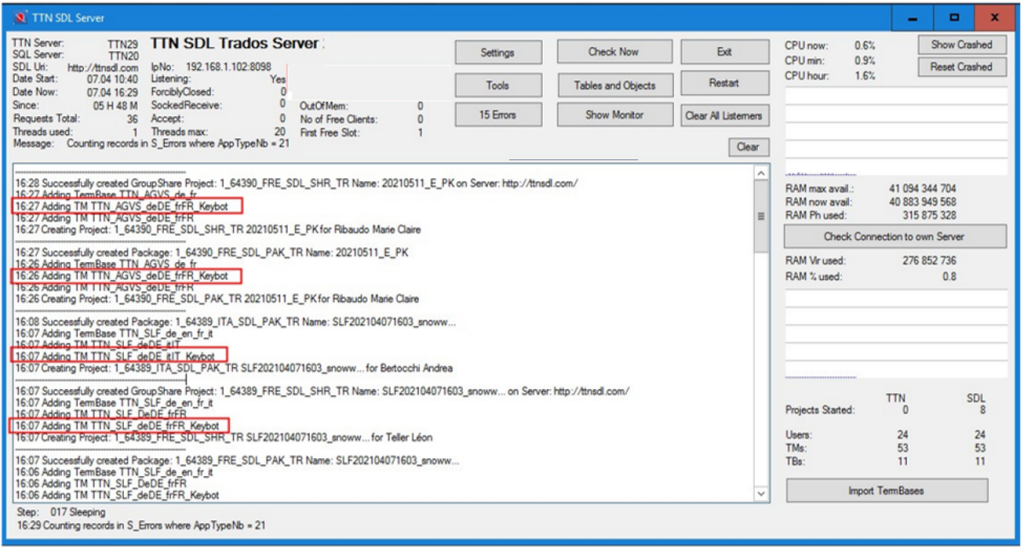
Figure 9 : Intégration automatique des mémoires de traduction de Keybot lors de la génération du projet
Une fois les textes parallèles extraits et alignés, ils sont convertis en mémoires de traduction et publiés directement sur le serveur GroupShare. Ces mémoires de traduction sont ensuite automatiquement ajoutées à chaque nouveau projet de traduction. En pratique, cela signifie que les traducteurs ont un accès immédiat à de vastes quantités de contenu traduit de haute qualité en rapport avec leur projet. Les données des mémoires de traduction constituent une référence précieuse, permettant aux linguistes de réutiliser des traductions éprouvées et de maintenir la cohérence sans aucune configuration manuelle.
Grâce à Web-to-TM, TTN TMS permet aux organisations d’exploiter tout le potentiel linguistique d’Internet. La plateforme peut automatiquement identifier et aligner les sites web multilingues – même pour les domaines où il n’existe pas de mémoire de traduction – et les transformer en de riches mémoires de traduction. Cela permet d’accélérer considérablement les projets de traduction, de garantir la cohérence de la terminologie et du style, et de réduire les coûts de traduction grâce à une réutilisation maximale des traductions existantes.
Avec Web-to-TM, des collections entières de documents, tels que des rapports annuels, des rapports de situation, des contrats, des normes techniques, des cadres réglementaires et des catalogues complets, sont alignées et indexées. Il en résulte une base de connaissances linguistiques complète, en constante évolution, qui améliore en permanence la qualité et l’efficacité des traductions.
En outre, les mémoires de traduction produites par Web-to-TM peuvent directement améliorer les systèmes de traduction pilotés par l’IA. L’intégration d’une mémoire de traduction avec des moteurs de traduction par l’IA modernes permet d’obtenir des traductions automatisées plus cohérentes et plus précises. L’IA peut s’appuyer sur les traductions de haute qualité vérifiées par l’homme dans la mémoire de traduction pour guider sa production, évitant ainsi les incohérences souvent observées dans les traductions automatiques brutes. En fait, des études ont montré que l’utilisation de contenus de mémoires de traduction existants avec des modèles d’IA générative peut considérablement améliorer la qualité de la traduction – une expérience a fait état d’une augmentation de 20 points du score BLEU après avoir fourni à l’IA des exemples de mémoire de traduction pertinents. En fait, la combinaison de la traduction assistée par l’IA et de mémoires de traduction robustes offre le meilleur des deux mondes : la rapidité et l’ampleur de la traduction automatique, ainsi que la précision et la fiabilité des traductions humaines. Cette synergie permet aux entreprises de développer une communication globale sans sacrifier la qualité.
Contrôle de qualité de l’IA
Qu’une traduction soit réalisée manuellement ou à l’aide d’un moteur de traduction automatique, la version initiale du traducteur et la version corrigée du texte sont soumises à un contrôle de qualité basé sur l’IA. Ce processus s’appuie actuellement sur un système d’intelligence artificielle de pointe pour obtenir les meilleurs résultats en matière de révision de la qualité des traductions.
Dans le cadre du contrôle de qualité de l’IA, le système envoie des segments individuels des fichiers XLIFF à un service d’IA pour évaluation. L’IA examine chaque segment pour en vérifier l’exactitude, la grammaire, l’orthographe, la cohérence terminologique et la qualité linguistique globale. Si l’IA identifie des problèmes, il les enregistre dans un tableau de rapport avec des références au segment correspondant dans le fichier XLIFF.
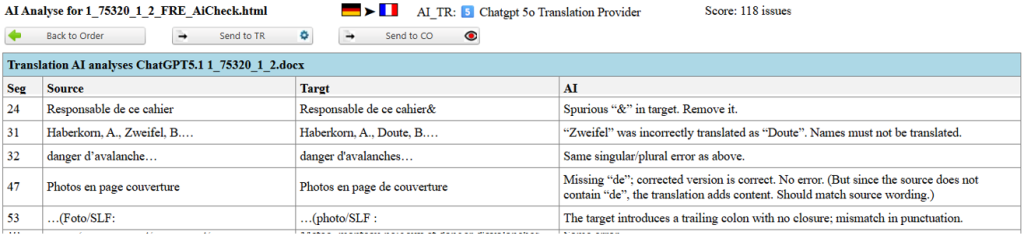
Figure 10 : Problèmes signalés dans le cadre du contrôle de qualité de l’IA
Cette vérification pilotée par l’IA met souvent en évidence des erreurs que les relecteurs humains pourraient ne pas voir. Par exemple, certains moteurs de traduction automatique tels que DeepL posent souvent le problème de la traduction littérale des noms propres. Des noms comme « Baker », « Fisher », « Cooper » ou « Turner » peuvent être traduits comme des mots ordinaires dans la langue cible au lieu d’être reconnus comme des noms. De même, des noms de lieux tels que « Hill », « Wood » ou « Brook » peuvent être mal traduits mot à mot. Par exemple, Greenpeace peut être rendu par DeepL comme la paix verte en français ou grüner Friede en allemand. Le système effectue en effet un double contrôle automatisé, en détectant ces erreurs et en les signalant pour vérification. Toutefois, il est important de noter que de nombreux problèmes signalés par l’IA sont des faux positifs ou des suggestions stylistiques mineures qui ne nécessitent aucune modification.
En pratique, le système produit un rapport de qualité généré par l’IA une fois que le traducteur a terminé la traduction initiale. Ce rapport est ensuite transmis au relecteur, qui examine les éléments signalés et traite les problèmes valables tout en écartant les suggestions incorrectes ou non pertinentes. Une fois que le relecteur a chargé la traduction révisée, le contrôle de qualité de l’IA s’effectue à nouveau sur le contenu mis à jour. Le système reconnaît les problèmes précédemment signalés qui ont été résolus et les omet dans les nouveaux résultats, ne signalant que les problèmes restants ou nouvellement détectés. À la fin de ce processus itératif, le responsable de la traduction reçoit un rapport final et concis des problèmes en suspens et peut rapidement vérifier si certains problèmes nécessitent encore une attention particulière.
Le contrôle de qualité de l’IA constitue un filet de sécurité efficace pour l’assurance qualité. Il détecte souvent des erreurs mineures mais critiques, telles que des fautes de frappe dans les titres ou les pages de garde, des erreurs dans les noms propres ou des mots omis. Ce contrôle automatisé supplémentaire constitue une garantie importante, car il permet d’éviter les erreurs dans les documents à fort enjeu, tels que les contrats importants ou les documents publiés, qui auraient pu passer inaperçus sans cette couche supplémentaire de contrôle de la qualité.
Le contrôle IA du point de vue du client
Pour le client, le contrôle IA n’est pas un détail technique, mais une étape de vérification supplémentaire et indépendante, incluse dans chaque commande. Il complète le principe du double contrôle sans le remplacer. Les sections suivantes résument les avantages concrets pour le client.
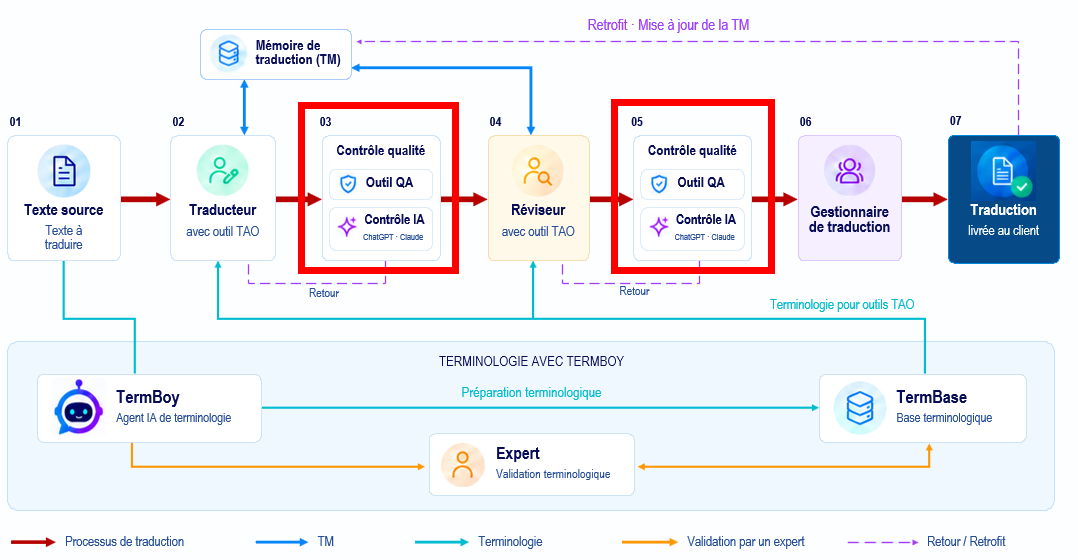
Figure 11 : Lors du contrôle IA, chaque segment traduit est vérifié avec un prompt spécifique au client
Deux contrôles qui détectent des erreurs différentes
L’outil de QA du système de TAO vérifie l’aspect formel de la traduction : nombres, dates, unités de mesure, ponctuation, balises, espaces avant les signes de ponctuation français et, surtout, le respect de la base terminologique. Le contrôle IA vérifie le contenu : la phrase cible signifie-t-elle la même chose que la phrase source ? Les deux procédés couvrent des classes d’erreurs différentes. Ensemble, ils forment un filet nettement plus serré que chaque contrôle pris isolément.
Un procédé mathématique – les omissions sautent aux yeux
Le modèle Transformer d’une IA représente le sens du segment source et du segment cible sous forme de vecteurs. Si ces vecteurs divergent sensiblement, le contrôle IA signale le segment pour vérification. C’est une approche fondamentalement différente de la relecture humaine : une proposition manquante, une négation oubliée ou un chiffre qui n’apparaît plus dans le texte cible n’échappent pratiquement jamais à ce procédé – pas même à la fin d’une longue journée de travail.
Contrôle croisé par un deuxième fournisseur
Lorsqu’un texte est traduit automatiquement, c’est toujours un autre modèle qui le vérifie : Claude contrôle ChatGPT, ChatGPT contrôle Claude. Aucune IA n’évalue son propre travail. Pour le client, ce contrôle IA-IA représente un véritable deuxième avis, et non une auto confirmation du fournisseur de traduction.
Règles spécifiques au pays et au client
Le contrôle IA est généré selon les règles du pays et de la langue cible. Pour les clients suisses, les directives de l’administration fédérale, les règles du langage inclusif et les guides de style des langues concernées sont pris en compte. Les règles internes de chaque client sont enregistrées en complément ; elles s’ajoutent aux règles standard sans les remplacer.
Une qualité documentée – même des mois plus tard
Pour chaque version d’un fichier – la version du traducteur et celle du relecteur – un rapport distinct est établi, avec le numéro de segment, le texte source, le texte cible et un commentaire. Les points déjà résolus disparaissent au passage suivant, de sorte que le rapport final ne contient plus que les questions ouvertes. Tous les rapports restent disponibles dans les archives des commandes et servent de preuve de qualité – pour les questions internes comme pour les audits ISO 17100.
Aucune infrastructure d’IA propre nécessaire
Le client n’a besoin ni d’un abonnement auprès d’un fournisseur d’IA ni d’expérience dans la rédaction de prompts. Le choix du modèle, le développement des prompts, les coûts de calcul et l’exploitation sont assurés par TTN et compris dans le prix de la commande. Les traducteurs impliqués n’ont pas non plus à acquérir de coûteuses versions Pro de Claude ou de ChatGPT.
Aussi pour les textes hors du circuit des commandes
Pour les appels d’offres, les traductions d’essai ou les traductions réalisées à l’externe, un contrôle IA indépendant de toute commande est disponible. Il est accessible via www.ttn.ch, dans la rubrique Teamwork, et vérifie tout fichier bilingue selon les mêmes règles.
Ce que le contrôle IA ne fait pas
Environ 50 % des points signalés sont des fausses alertes ou des suggestions stylistiques discutables qui peuvent être ignorées. La valeur du procédé réside dans les rares cas où une erreur grave est découverte avant que le texte n’arrive chez son destinataire. Le contrôle IA ne remplace donc ni le relecteur ni la vérification spécialisée par le client – il est le filet de sécurité en dessous. Il suppose en outre un fichier bilingue dans lequel le texte source et le texte cible sont liés segment par segment : SDLXLIFF pour Trados, PPF pour Transit ou un document Word de révision bilingue. Le contrôle est déclenché par commande et peut être omis pour les textes soumis à des exigences de confidentialité particulières.